 免费试用
导语:月初做月报,工艺员先花一上午从三张表里摘数,再花一下午核对两边的差异,最后剩两个小时写分析。真正需要判断的部分被挤到最末,遇到加班还会直接跳过。AI生产报表自动生成 要接的,是前半段那些重复的整理与核对动作,把时间还给能产生判断的那两个小时,分析才不会在赶工时最先被砍掉,价值才留得下来。
月报的时间,真正被吃掉的是哪一段?
报表耗时的多寡通常不在分析环节,而在取数与核对;这部分做得越久,留给判断的时间越少,熟练的人也不例外;它本来属于分析。
多数工厂的月报是这样完成的:从生产系统导出产量,从仓库导出领料,从考勤导出工时,再在个人表格里拼成一张汇总表。三份数据的口径不完全一致,拼在一起之后总要花时间解释差异。
这类工作有一个特点:熟练的人做得快,但快也快得有限。表格越复杂,出错概率越高,反复核对又进一步拉长周期。更重要的是,这些动作不产生任何新判断。
所以讨论报表自动化之前,先要分清两件事:整理与判断。前者适合交给工具,后者必须留给人。
这些动作还有一个隐性代价:它把最有经验的人绑在案头。熟悉口径的工艺员往往正是现场最需要的人,却每个月要在表格上耗掉两三天。
整理这一段,AI生产报表自动生成 接得最稳
自动生成解决的是取数与汇总,不解决口径与结论;两件事混在一起谈,期待很容易落空,落地时双方也容易互相埋怨;顺序也就颠倒了。
AI生产报表自动生成 能做好的,是把分散的记录按既定口径汇到一起:产量按工序汇总、不良按类型汇总、工时按班组汇总,并把异常值标出来提醒复核。
它做不了的是判断这些数字意味着什么。产量下滑是因为订单减少还是设备停机,不良上升是工艺问题还是来料问题,这些需要结合现场情况去解释,工具只能提供线索。
从行业投入看,这类能力正在变得常见。Gartner 在 2025 年 11 月发布的市场预测中提到,全球低代码开发技术市场到 2029 年将达到 582 亿美元,2024 至 2029 年的复合增长率为 14.1%,推动因素包括智能体 AI 与业务人员的深度参与。
这两件事的边界在实操中容易模糊:比如“产量下降”,系统能告诉人下降了多少、集中在哪个班组,但为什么下降仍需结合订单与设备情况解释。自动生成也不等于自动决策,要不要调整排产、加派人手,仍由人定。
数据不整齐时,自动生成会出什么问题?
源头不统一,自动化只会把错误放大;口径没对齐就上自动化,报表出得越快反而越容易误导现场判断,越自动越需要先对齐。
最常见的问题是同一件事有多套算法。产量算不算返修件、工时算不算加班、良率按工序算还是按最终成品算,如果这些定义在不同部门之间不一致,自动生成的结果就会与部门自己的账对不上。
第二个问题是字段缺失。自动汇总依赖固定字段,若现场填报时经常留空,汇总结果就会出现无法解释的空档,而人看表格时往往会忽略这些空档。
第三个问题更隐蔽:口径会随时间变化。工艺调整后统计方式跟着变,若没有版本记录,同比与环比就失去了可比性。
字段缺失的影响常被低估。汇总时少一列,看起来只是数字偏小,但据此做出的产能判断会直接偏掉,而这种偏差在人工复核时并不容易发现。
河北塑创的报工统计提速,动的是哪一步
把高频且容易起争议的环节先搬上系统,效果最容易被一线感知,推广时遇到的阻力也会随之下降,口碑先立住后续会顺很多。
中小制造企业的数字化起点往往很朴素。河北塑创有近 25 年历史,此前付款管理、员工报工与审批长期依赖人工和微信群,统计慢、核对成本高,虚报与差错的问题也比较突出。
它的做法是先落地合同付款与员工报工这两个高频场景。副总经理在试用之后用半个月完成流程梳理与系统搭建,报工数据统计效率提升 80%,工资计算准确率达到 100%,对账时间从 3 天缩短到 1 小时,计件虚报问题减少 95%,目前已经构建 50 多个数字化流程,其中相当一部分运行在 轻流 上。
这段经验的可借鉴之处在于顺序:先做与钱直接相关、争议最多的报工,数据准确度上来之后,再谈报表自动化与产量分析,阻力会小很多。
还有一种边界情况值得提前想清楚:跨月工单怎么归属。是按开工月还是完工月统计,两个口径得到的结果差别不小。
哪几类报表最先值得自动化
优先做频次高、口径稳定、用途明确的报表;低频又常变口径的先放一放,等它稳定下来再考虑,一次全做往往半途而废;节奏比全面更重要。
从哪里开始自动化更稳妥
- 生产日报:产量、不良、停机时长,每天早会要用,频次最高。
- 计件与工时报表:与工资相关,人工计算既慢又容易起争议。
- 物料收发存:数据来源固定,适合按周自动汇总。
- 交付达成率:口径明确,用于检验计划准确性。
判断优先级的办法很简单:问一句“如果这张表每周能省两小时,这两小时会用来做什么”。答得上来,说明它值得做;答不上来,说明它只是看起来重要。
四类报表之外,还有一类值得留意:临时性的专项统计。这类需求口径不固定,适合先在表格里完成,等它变成每月都要做的固定动作,再考虑自动化。
排优先级时还要考虑维护成本。一张每天都要看的报表,值得把口径做细;一年用两三次的,先保持现状即可。
自动生成的报表,怎么防止越用越偏?
给口径加版本、给异常留复核口,是防止报表慢慢失真的两件事,成本不高,却决定了这些数据能不能被长期信任,这一点不能省。
版本管理指的是口径变更时留下痕迹。比如良率的计算方式调整,就应当记录生效日期与调整原因,让历史数据仍能按当时的规则解释。
异常复核指的是自动生成的报表要有一个人工确认环节。数字明显偏离常态时,系统先标出来,由对应岗位确认是真实变化还是记录问题。这一步看起来多余,实际能挡住相当一部分失真的数据流向下游。
复核环节也可以分级。波动在可解释范围内的直接发布,超出范围的需要对应岗位确认后发布,这样既不必事事确认,也不会漏掉真正的异常。
这一部分的关键结论:AI生产报表自动生成 省下的是整理时间,不替代口径定义与业务判断;口径不统一时,自动化只会让偏差出现得更快。
源头没理顺,自动化只会放大偏差
自动化的前提是记录已经电子化、口径也一致。这两样不具备时,把基础补齐比上工具更快见效,钱也不会白花,顺序反了只会返工。
| 更适合先上 | 暂不适合 |
|---|---|
| 报工与产量已电子化记录 | 现场仍以纸质单据为主 |
| 核心口径已统一并写入制度 | 各部门对同一指标理解不同 |
| 报表频次高、用途明确 | 报表只在年末汇总一次 |
| 有专人负责数据复核 | 没有任何岗位对数据质量负责 |
暂不适合时,可以先做一件低成本的事:把现有报表的口径与来源写成一页说明。这份说明是将来做自动化的直接输入,也能立刻减少日常的口径争论。
提醒:自动生成的数字,建议只当内部参考,不直接对外。凡涉及结算、索赔或客户交付承诺的数据,建议保留一次人工确认。原因不是不信任工具,而是数据链条上任何一个环节的记录偏差,都会在汇总之后被成倍放大,而人工确认目前仍是成本最低的一道闸。
暂缓期间还有一件值得做的事:把现有报表的使用者与使用场景记录下来。哪些表是早会必看、哪些表只在检查时调取,这份清单能直接决定将来自动化的优先顺序。
同时建议保留一条反馈通道。使用报表的人如果发现某个数字明显不符合现场情况,应当有渠道提出,而不是默默忽略。
口径不统一,AI生产报表自动生成 会加速出错
产量、工时、不良这三项是绝大多数报表的底层数据;三者口径统一,自动化才有稳定的输入,否则报得越快越乱;统一口径再谈效率。
- AI生产数据分析报表:先从日报与周报做起,月报的复杂度更高。
- AI报表自动生成:自动生成的范围限定在取数与汇总,结论仍由人写。
- 生产报表系统:报表的字段来源要写清,避免同一指标多处取数。
- 产量统计系统:明确返修件与试制件是否计入产量。
- AI生产管理系统解决方案:报表是入口,后续可接入异常与质量数据。
- 生产日报自动汇总:日报按时发布比精细更重要,先稳定再优化。
最后一点建议:把省下来的时间明确用在一处,比如每周固定开一次数据分析会,否则省下的时间会被新的琐事填满,报表自动化就只剩下形式上的价值。
另外建议把报表的阅读者也列出来。同一张日报,班组长看的是当班任务,管理层看的是趋势,口径和颗粒度需求并不一样。
总结:报表的耗时多花在整理上,真正用于判断的时间其实相当有限。AI生产报表自动生成 适合承接取数与汇总,口径与结论仍要人来定。自动化能省的是手上的活,省不了判断:归类规则与异常口径仍要有人定期回看,也要有人签字。真要动手,先让报工与产量进同一条链路;源头干净了,日报自己会浮出来,这一步交给 轻流 承接,代价最低。
常见问题
Q1:自动生成的报表能不能直接用于结算?
建议保留一次人工确认。结算类数据涉及金额与责任,数据链条上任何一处记录偏差都会被汇总放大。更稳妥的做法是让系统自动生成并标注出异常项,由对应岗位确认后再对外使用。这样既保留了自动化的效率,也留住了可追溯的责任节点,出问题时能快速定位到具体环节,减少来回扯皮。
Q2:报表口径经常变,自动化是不是就做不成?
可以做成,但要给口径加版本。记录每次调整的生效日期与原因,历史数据仍按当时的规则解释,新数据按新规则生成。这样一来,同比与环比就不会被口径变化污染。若一年内口径变动超过三次,建议先停下来复盘,看看是不是指标定义本身还不够清晰,而不是急着把每一次口径变动都搬进系统。
Q3:先做日报还是先做月报?
建议先做日报。日报的频次高、用途明确、问题暴露得也快,跑两周就能判断口径是否合理;月报周期长,等发现问题已经过去一个月,调整成本更高。等日报稳定之后,月报往往只需要在日报的基础上做一次汇总,工作量会明显下降,口径也不容易在多次汇总中走偏,团队也少了一层重复劳动,注意力能回到异常本身。

-
MES系统和ERP系统区别,别用一套系统硬扛
 两套系统各说各话,月底对账时最能看出来:ERP 说订单已完工,车间说还有一道工序没做。MES系统和ERP系统区别 的核心在回答的问题不同,一个管经营核算,一个管车间执行;边界写不清,集成做完仍然对不上。轻流AI无代码平台 常被放在两者之间,承接变化快的现场流程,智能硬件企业惠威科技就是从订单到回款这条端到端流程……2026-09-18
-
AI生产报表自动生成,省下的是整理那一段
做一份月报,三天里有两天半在贴数据,真正分析的时间不到半天。AI生产报表自动生成 能接走的正是整理这一段:取数、对表、按口径汇总,而判断与结论仍要由人给出。轻流AI无代码平台 把报工、库存与工单数据放在同一处,汽车零部件企业河北塑创借它把报工统计与对账都搬到了线上。这条路的门槛不在工具而在源头;记录方式还没统一……2026-09-18 -
车间异常报了没人管,生产异常管理系统该怎么配
 同一条异常在群里转了三手,最后谁在处理反而没人说得清。问题多半不在态度,而在分类、指派、验收这三个环节断了一处。生产异常管理系统 的起点不在上报入口,而在异常类型表:分类不定,责任就落不到人。轻流AI无代码平台 把上报、指派与复检放在一条流程里,钢铁制品企业美达王借此把现场岗位的记录搬到移动端。类型单一、车间内……2026-09-18
-
工序管理系统画得再细,报工不填也是白搭
 工序图画得再完整,只要报工没有按时回填,这套数据就用不起来。工序管理系统 的价值在流转规则:谁交给谁、什么时候确认、异常怎么退回,而不是图形画得多好看。轻流AI无代码平台 让业务人员自己调整工序与表单,汽车电子企业承泰科技借它把研发与量产的流程先固化下来。值得先花时间的不是流程配置,而是叫法:同一道工序有三个名……2026-09-18
-
生产排产系统排不准,问题多半不在算法
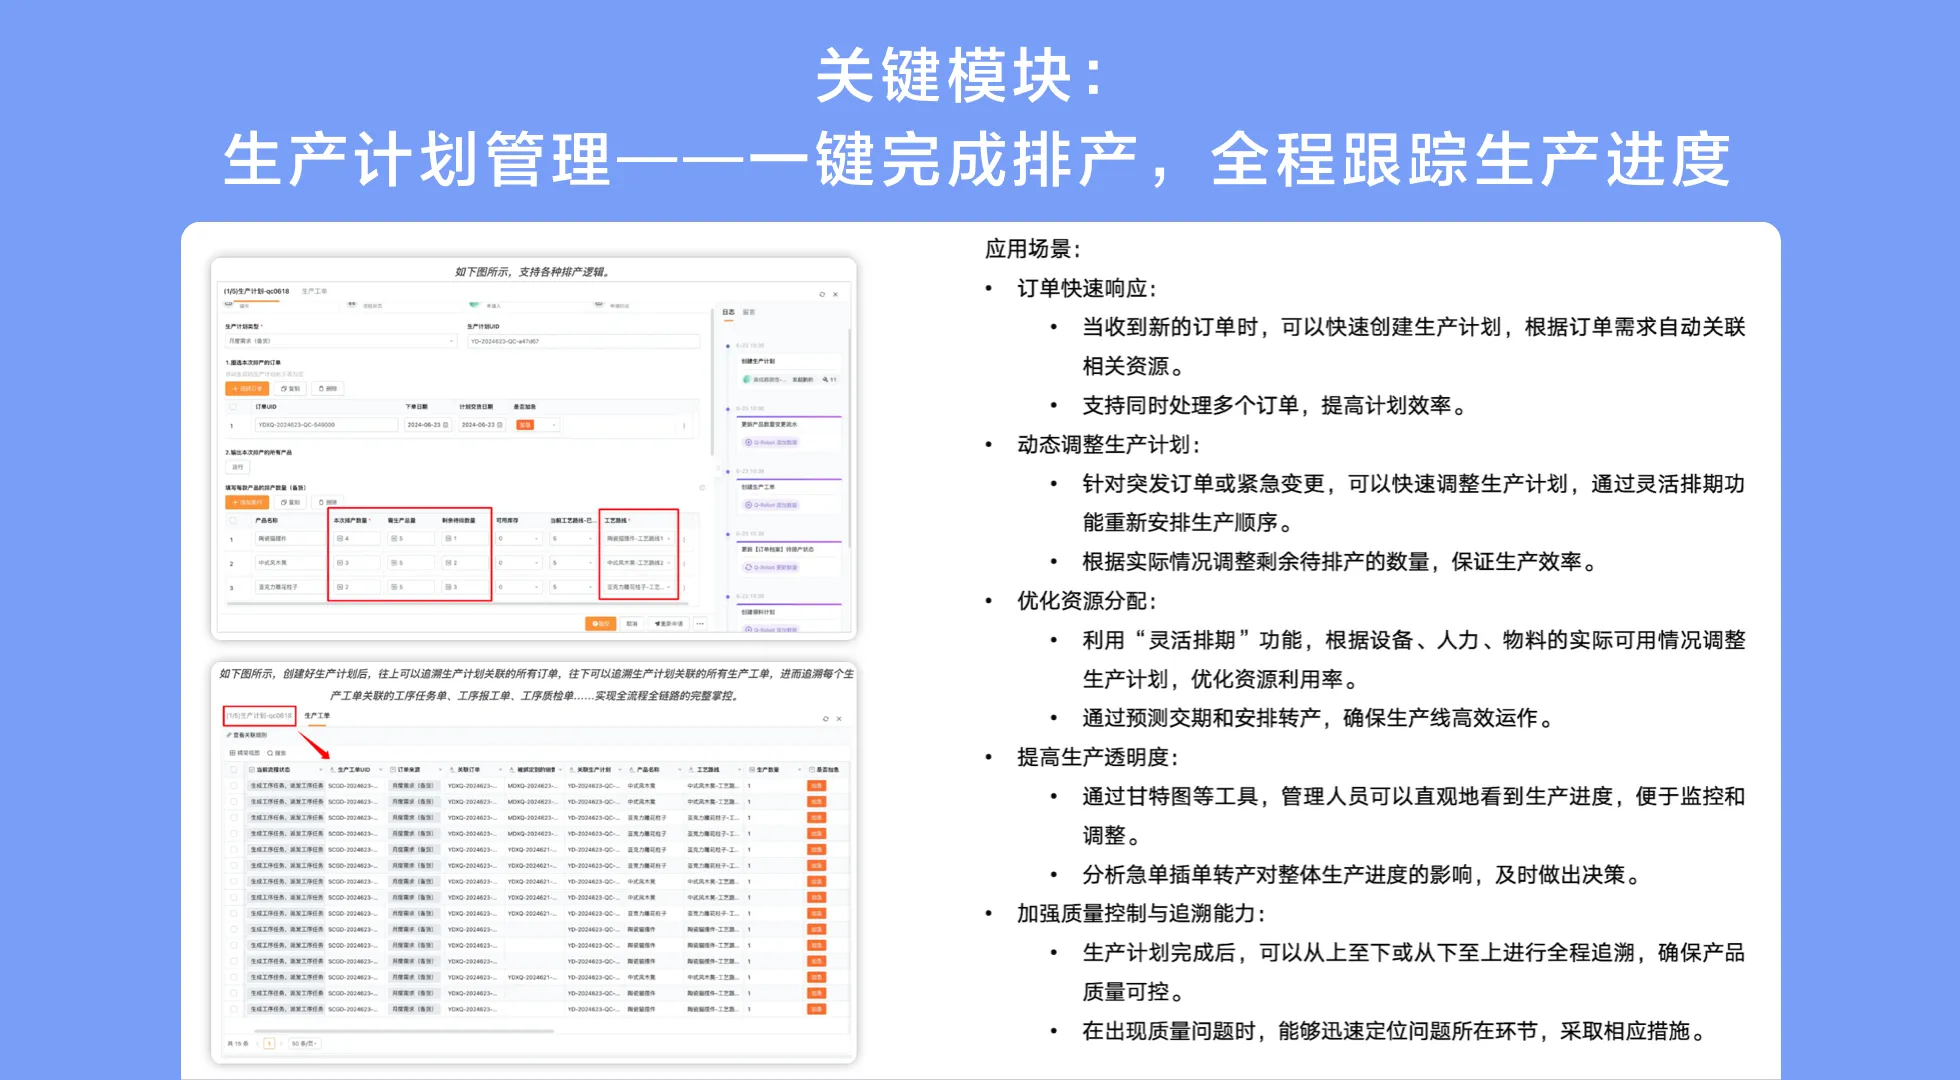 排产结果落不了地,多数时候不是算法不够聪明,而是喂给它的输入本身不成立:工时靠估、换型时间没统计、物料能否齐套也不确定。生产排产系统 要解决的首先是输入的可信度,其次才是顺序优化。轻流AI无代码平台 把订单、物料与机台工时放在同一套表单里,让排产依据可查。排序工具并不稀缺,稀缺的是可信的工时与换型数据;这两样没……2026-09-18
-
无代码MES系统怎么搭才不沦为电子表
无代码MES系统指用无代码平台按需搭建MES相关模块,优势在业务变了自己能改,而非买固定模板。本文以锻造企业奥斯锻造为例,它因重型方案业务逻辑不匹配、改不动,用轻流AI无代码平台搭建个性化ERP实现全业务闭环。文章对比无代码与定制开发、与云表类制造业平台差异,并给出决策打分与试点路线,说明无代码MES系统适合流……2026-09-17 -
生产订单管理系统:参数改了怎么同步
生产订单管理系统管的是从接单到交付的订单主数据,尤其技术参数、交期与修改记录能否跨部门同步。本文以发电机组企业江苏万泰动力为例,它客户需求变快、合同参数交期散在微信Excel纸质单,用轻流AI无代码平台把参数修改记录交付日期统一到一条时间轴。文章拆解订单为何断点、主数据怎么设、变更怎么管理,并说明生产订单管理系……2026-09-17 -
生产数据追溯系统:为何追不到哪批料
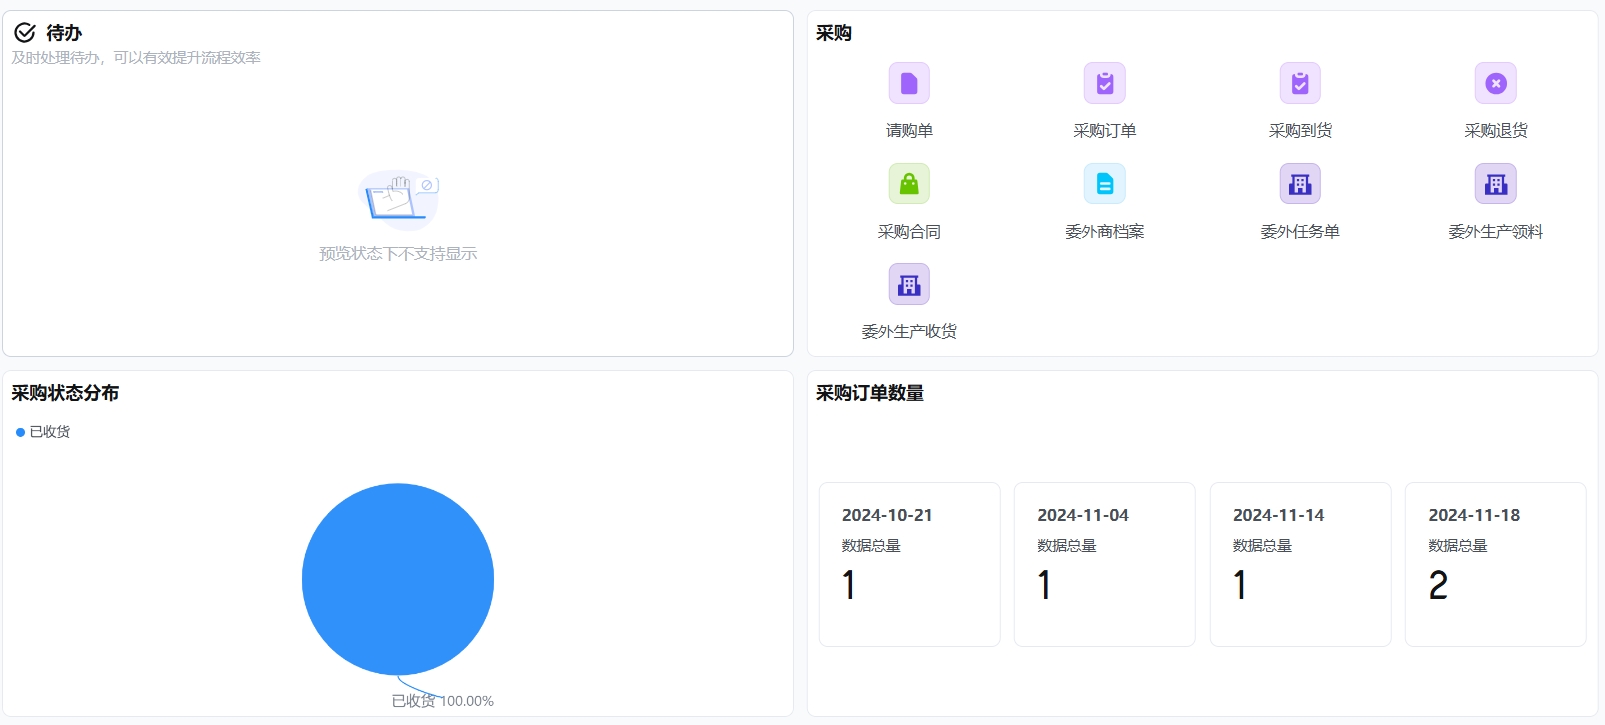 生产数据追溯系统管的是从订单、BOM、批次、工序到设备的正向与反向链路,出问题时能定位哪批料、哪台设备、哪道工序。本文以电子制造企业辰硕科技为例,它用轻流AI无代码平台搭建覆盖BOM、生产、锡膏、钢网的系统,并形成次品率与设备分析看板。文章拆解追溯链条字段、批次管理、质检记录,并说明生产数据追溯系统可参照ISO……2026-09-17
-
生产报工管理系统怎么防虚报
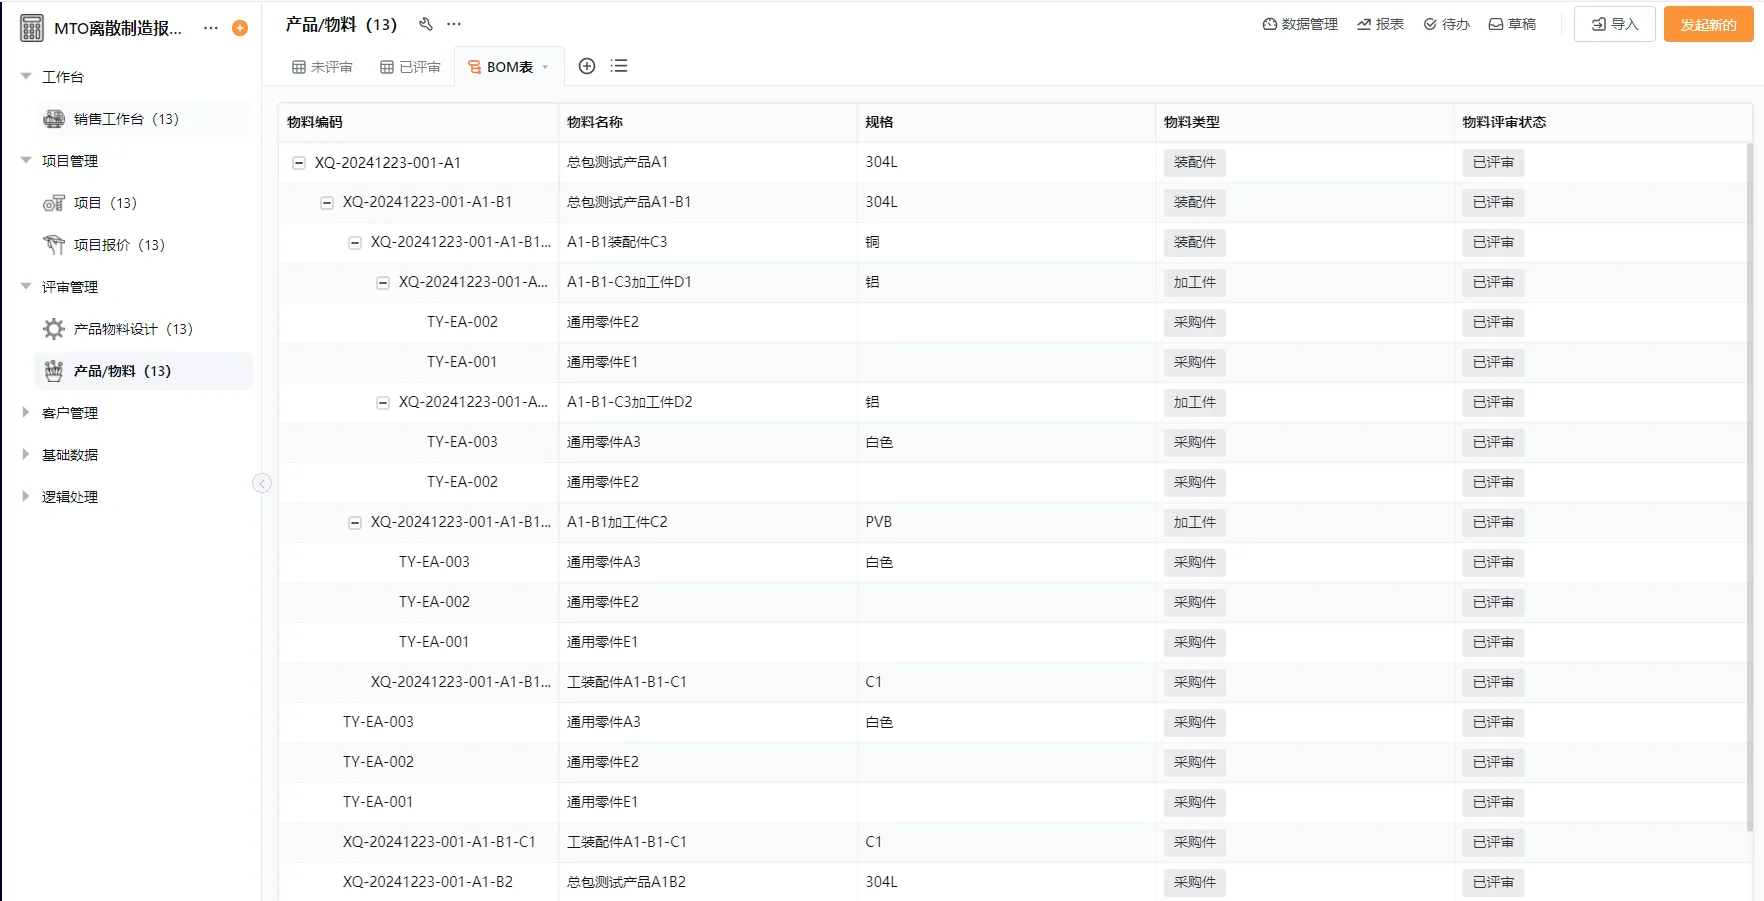 生产报工管理系统解决的是工时和产量谁来做、做了多少、何时回填的问题,计件计时都要有凭有据。本文以汽车零部件企业河北塑创为例,它用轻流AI无代码平台落地移动报工与自动对账,报工统计效率提升八成、计件虚报减少九成五。文章拆解计时计件怎么记、移动报工怎么落地、报工如何连工资,并说明生产报工管理系统要先定义工序与计件规……2026-09-17
-
制造企业数字化先从哪条产线破局
制造企业数字化不是一次性上全套系统,而是从一条高频产线或一个关键场景试点,再逐步扩展。本文以定制家具企业渝维家具为例,它用轻流AI无代码平台搭建CRM、项目、生产等应用,形成覆盖销售订单到采购、排单、交付的数据驾驶舱。文章拆解非标制造为何难、订单如何作主轴、设计生产采购交付怎么协同,并说明制造企业数字化要先围绕……2026-09-17
轻客CRM
轻银费控

生产管理
质检管理
人事管理


